Del gráfico al criterio de decisión: ¿Por qué seguimos usando cuadrantes?
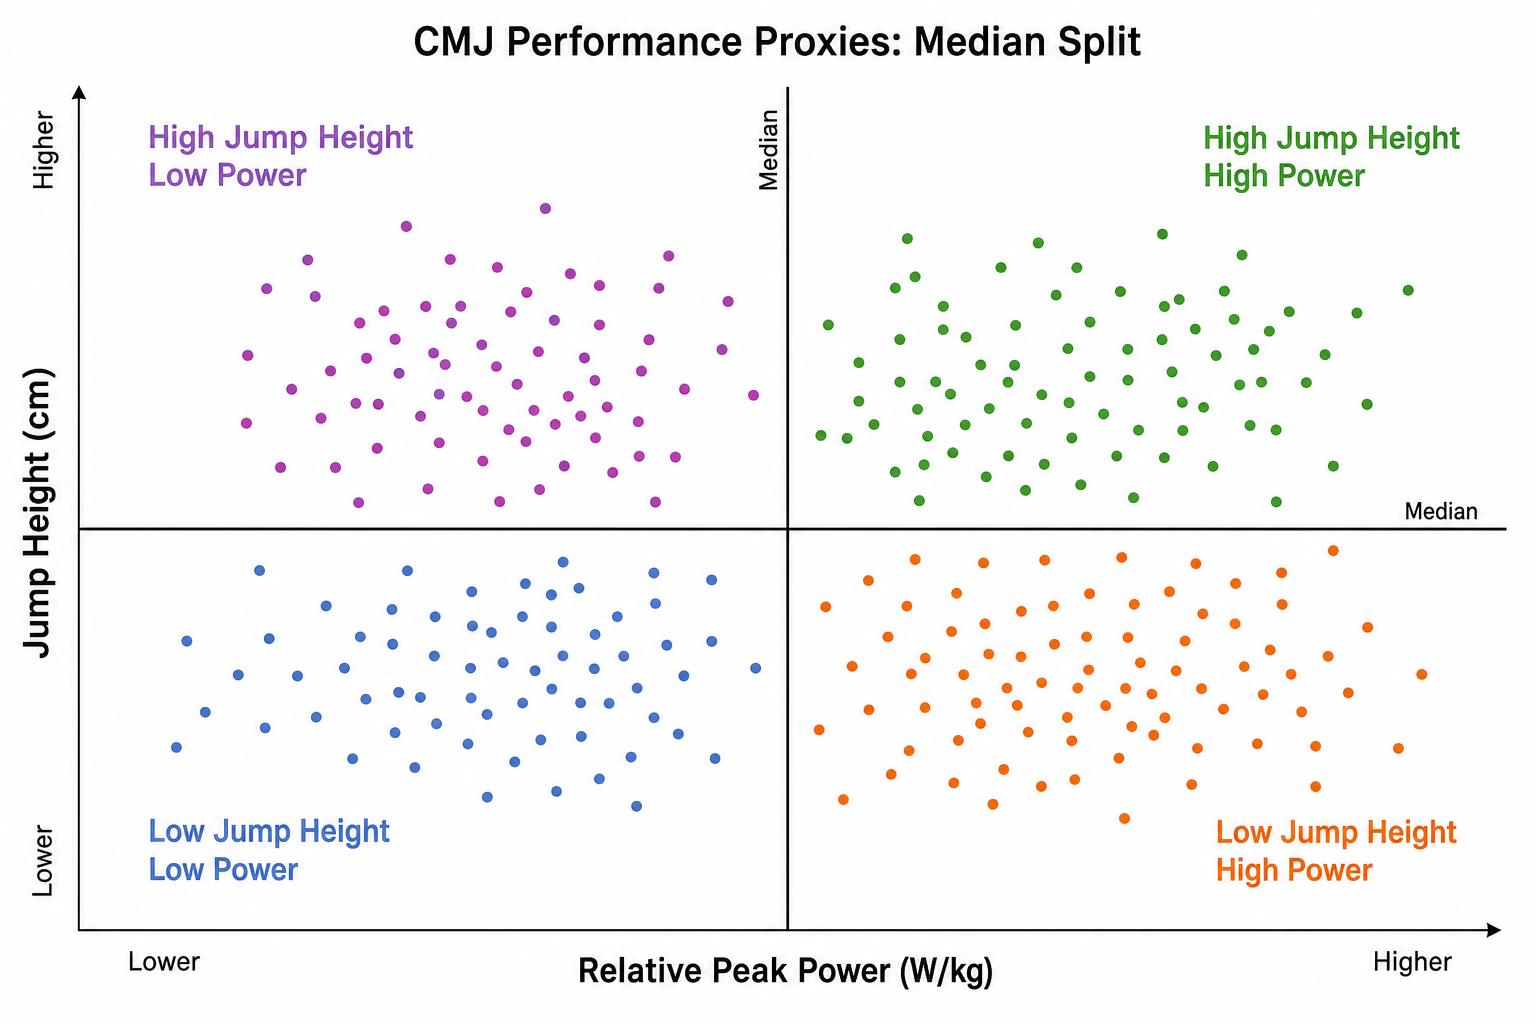
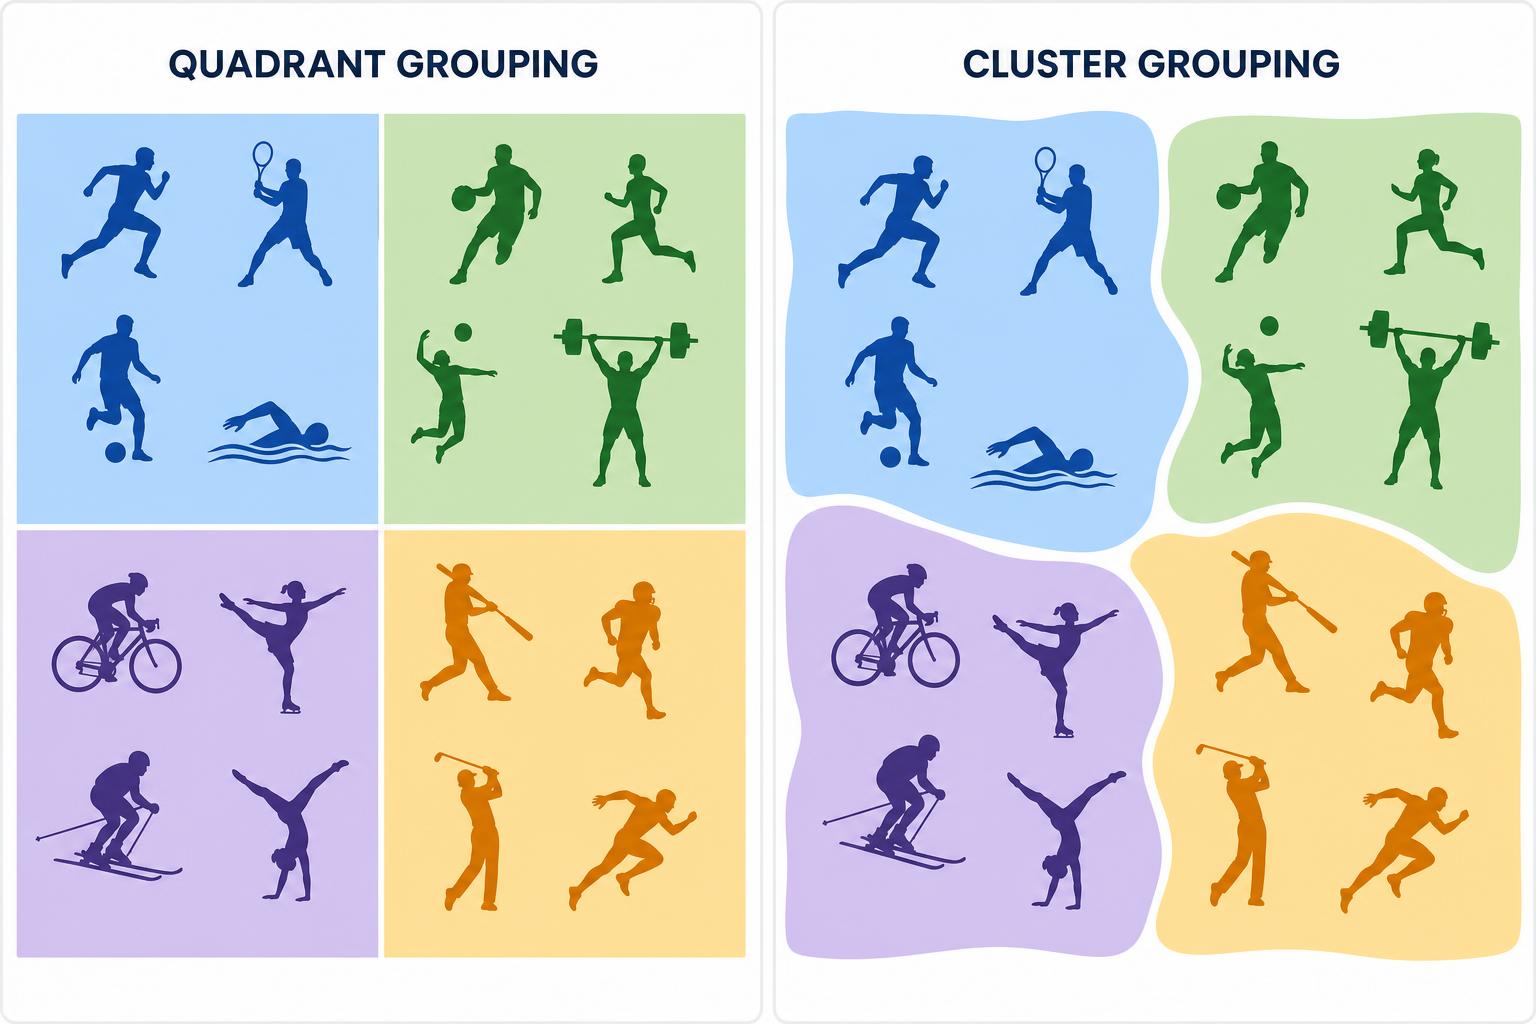
Casi todos quienes laburamos en evaluación deportiva hemos usado alguna vez el clásico gráfico de dispersión para comparar dos proxies: impulso propulsivo versus de frenado, CMJ vs IMTP, etc. Es intuitivo, visualmente potente y permite dar un pantallazo rápido sobre la composición del grupo tras el test de salto. La tradición marca que, para pasar de la nube de puntos a una estrategia de acción, se trazan líneas (media, mediana, percentil) generando cuatro cuadrantes: fuertes, explosivos, balanceados o deficitarios. Esa segmentación, tan tentadora por su simpleza, termina decidiendo mucho más que una label. Direcciona el feedback al atleta, legitima comparaciones grupales, justifica decisiones de programación y hasta puede sesgar discusiones de staff.
¿Pero realmente esos cuadrantes existen, o simplemente nos resultan cómodos para salir del paso? El desafío, y el atractivo de pensarlo hoy desde el aprendizaje automático, es revisar qué consecuencias tiene seguir eligiendo cuadrantes por sobre métodos que dejan hablar a los datos. No es sumar otra complicación por sofisticación, sino preguntarse si la forma en que estamos perfilando condiciona la calidad de lo que después decidimos en el campo. No es una grieta técnica, sino reconocer cuándo ese enfoque cumple un rol operativo real y dónde empieza a destruir más que construir.
¿Qué mide realmente el cuadrante y qué asumimos que mide?
Vale la pena frenar y pensar: ¿el cuadrante está describiendo un fenómeno atlético auténtico, o simplemente nos muestra cómo los valores se distribuyen en nuestro grupo de muestra, con fronteras puestas a mano? Cuando cortamos por la media del impulso propulsivo o de frenado, lo único que obtenemos es la posición relativa de cada atleta respecto a sus pares, no la confirmación de un subgrupo biológico distinto. Puede que un atleta caiga en el “cuadrante fuerte” porque ese año la media fue baja; al año siguiente, sin cambiar su output, podría quedar clasificado como “déficitario” porque se sumó un outlier en el grupo… ¿Es real ese salto de perfil, o es puro artifacto estadístico?
Mucho de la mitología que recubre el cuadrante viene de asumir que esas divisiones reflejan realidades discretas: atletas “explosivos” o “absorbentes” como si fueran categorías preexistentes. Pensamos que la pertenencia a un cuadrante implica características físicas definidas—un atleta “explosivo” tiene esa cualidad como una propiedad emergente y diferenciada—, pero la frontera entre un grupo y otro rara vez es tan clara. Se supone que leemos “tipos biomecánicos” cuando en realidad estamos graficando rangos relativos dentro de la muestra disponible. Sin una justificación fisiológica fuerte para el corte, el límite entre un perfil y otro puede ser caprichoso.
Entonces: ¿sirve el cuadrante? Sí, para comparar a atletas entre sí en ese momento y contexto específico, y siempre como una foto, no como una etiqueta permanente. El problema es cuando sobre-interpretamos esa foto como si fuera un documento de identidad atlética, y de ahí saltamos a adaptar carga o decidir readaptaciones bajo ese supuesto. El salto conceptual de repartir atletas en cuadrantes a entenderlos como entidades discretas casi nunca resiste el test de transferencia en el día a día.
El problema de las categorías impuestas sobre proxies biomecánicos
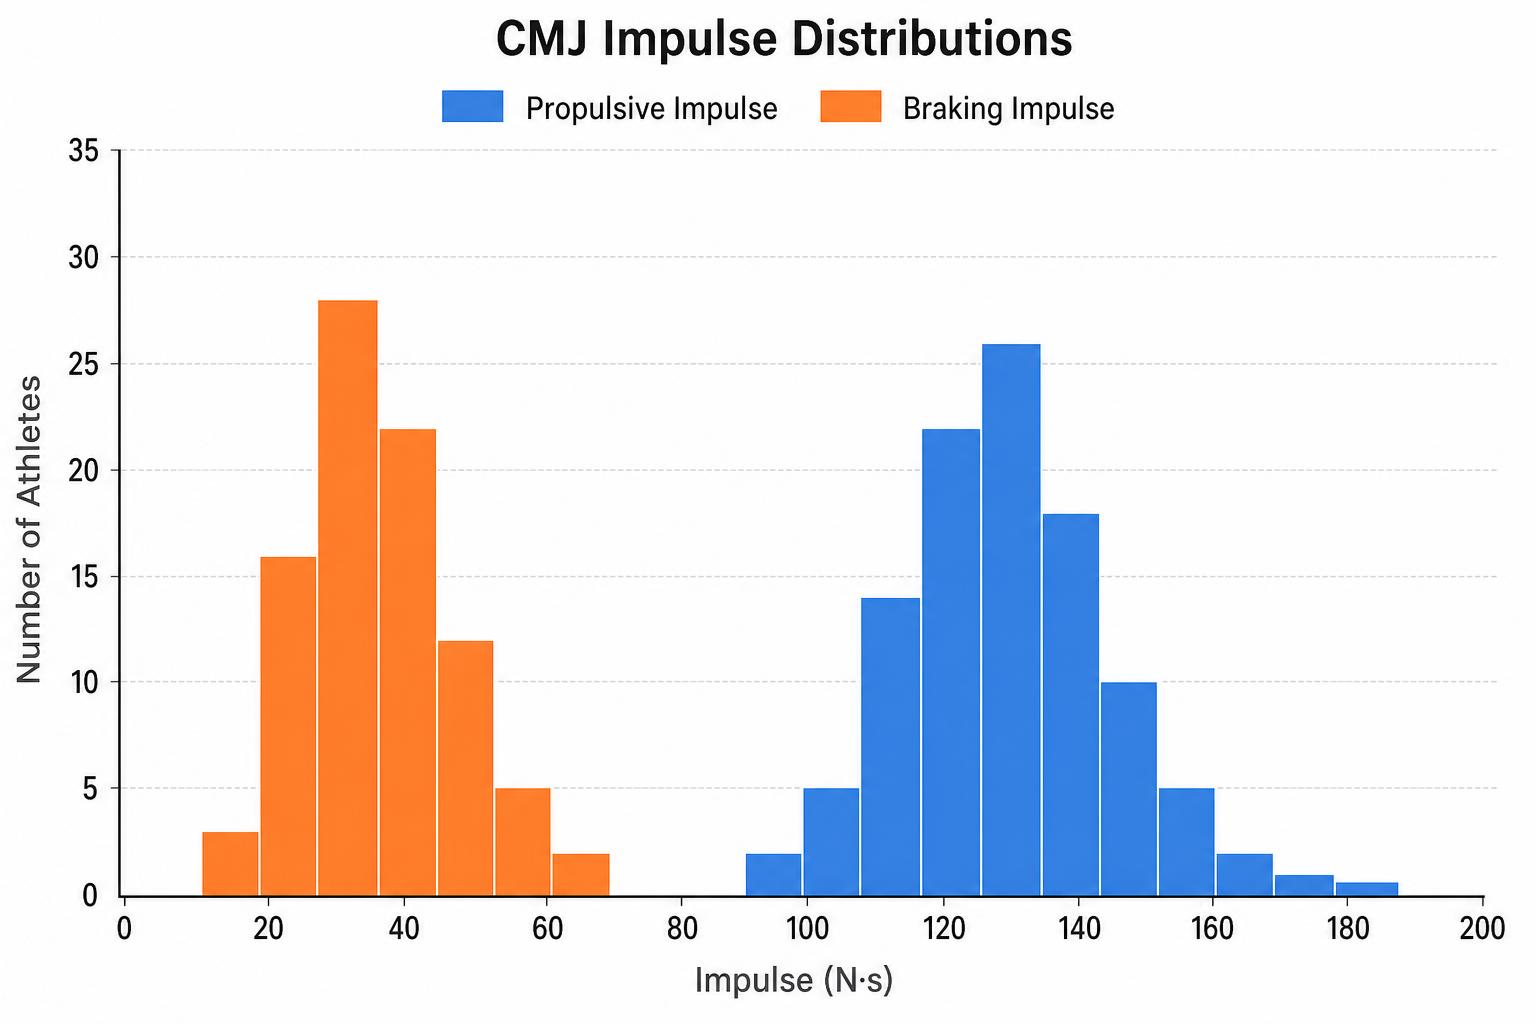
El CMJ es probablemente la prueba más popular para intentar rastrear cualidades explosivas, fuerza reaprovechada o capacidad de acción-reactiva. Sus variables, desde el impulso de frenado al propulsivo, no dejan de ser proxies: aproximaciones a esos constructos que en la práctica nos importan. Pero una vez que bajamos esos valores a un gráfico y los cruzamos en dos ejes, resolvemos la cuestión con una segmentación cuadrante, saltando de medición a interpretación con un solo trazo dasheado.
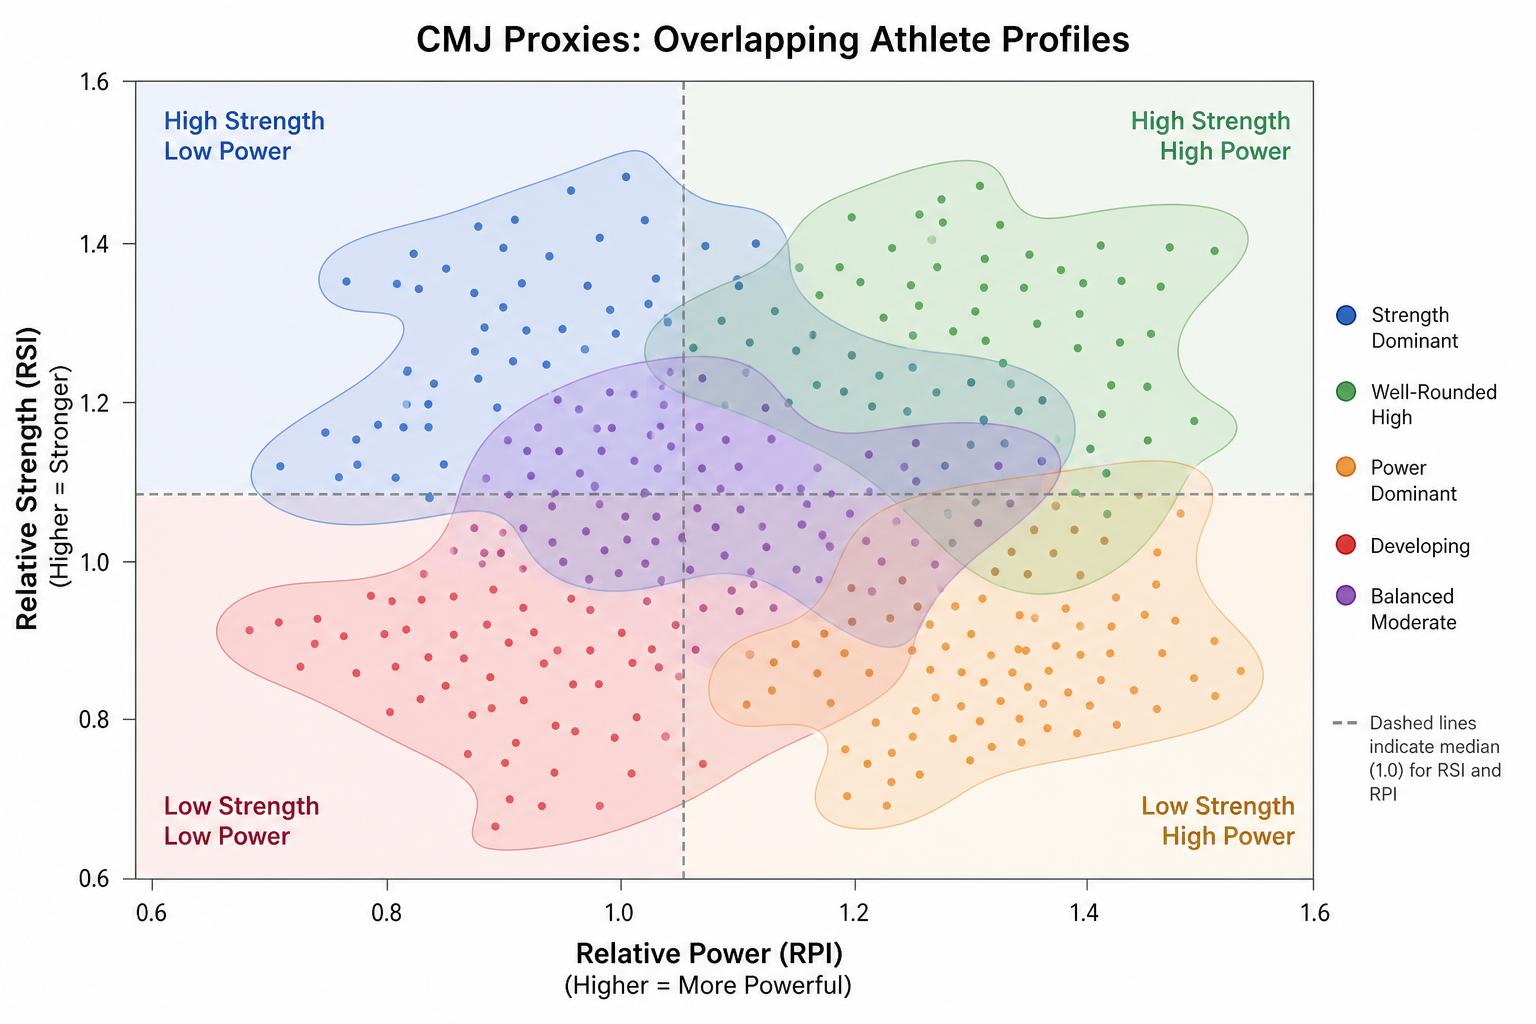
¿Qué perdemos en el proceso? Primero, la dimensión multidimensional real: el rendimiento humano rara vez se explica en dos variables. Segundo, la sensibilidad a cambios espurios: basta que un dato extremo entre en la planilla, y toda la media (y sus cuadrantes asociados) se desfasan, alterando la “clasificación” de atletas que no cambiaron nada. Y lo más preocupante, la reducción artificial a fronteras rectas que no existen en la naturaleza: la estructura subyacente puede ser de gradientes, clústers irregulares, solapamientos o agrupaciones no lineales. La comodidad del cuadrante, a veces, termina costándonos perspectiva interpretativa, sobre todo cuando las decisiones posteriores dependen de esos perfiles.
- Reducción de la complejidad: Exigir que toda la riqueza de la física atlética entre en cuatro etiquetas.
- Sensibilidad a outliers: Un error de medición desplazando perfiles de todo el grupo.
- Frágil frente a cambios de muestra: Variar la cohorte y las fronteras dejan de significar lo mismo. Imaginá que a mitad del año el plantel suma o pierde atletas con perfiles atípicos. El corte de la media se mueve y la comparación longitudinal se empieza a desarmar.
- Limitación lógica: El cuadrante presupone que hay exactamente cuatro perfiles, y que todos son igual de representativos, variante raras veces sostenida en la data real.
La conclusión es simple: la interpretación está atada a la frontera que elegimos y no necesariamente a la naturaleza del fenómeno que queremos comprender o intervenir. Si apostamos a la personalización, conviene algo más flexible y menos propenso a error de clasificación por corte fortuito. Tampoco el clustering es el santo grial, pero deja menos margen a la arbitrariedad y obliga a ajustar la estrategia sobre lo que emerge, no sobre lo que decidimos imponer.
La promesa (y los límites) del clustering en el profiling deportivo
Si aceptamos que la frontera del cuadrante es más una comodidad que una ley natural, tiene sentido abrir el juego al clustering. No porque el clustering sea una solución mágica, sino porque permite no imponer categorías y dejar que emerjan agrupaciones reales de la data acumulada en las propias pruebas. La lógica: algoritmos como K-Means o DBSCAN exploran la presencia de subgrupos, clusters o estructuras que no surgen de la decisión previa del staff, sino del parecido real entre las muestras recogidas. Así, el perfil no es “lo que corta la media”, sino lo que aparece en el comportamiento conjunto de los atletas. Y esto, cuando se traslada a la acción, puede cambiar por completo la orientación de una intervención o el seguimiento periódico de los perfiles.
A nivel práctico esto significa que los clusters pueden revelar, por ejemplo, subgrupos de atletas que, combinando propulsive y braking impulse, muestran patrones consistentes ajenos a la frontera recta del cuadrante. Se pueden descubrir agrupaciones mixtas (fuerte en uno, borderline en otro) o perfiles híbridos que un sistema binario nunca muestra—casos útiles si la individualización es prioridad. Además, el clustering resiste mejor el impacto de outliers o variaciones muestrales menores: agrega una capa de robustez frente al ruido estadístico del cohort.
Ahora, dos advertencias: el clustering pide una muestra mínimamente representativa—con menos de 15-20 atletas, es fácil que los patrones emergidos también sean accidentales. Y, por sí solo, el clustering es una foto descriptiva, no un sistema de clasificación dinámica. Cuando entra alguien nuevo, no asigna perfil automáticamente; para eso entra en juego el KNN (K-Nearest Neighbors): uso el mapeo previo y clasifico el nuevo caso asignándolo al cluster más próximo. De esa manera, lo aprendido no se desarma con las nuevas incorporaciones y el sistema gana en reproducibilidad.
Aplicando clustering y KNN, paso a paso sobre muestra de CMJ
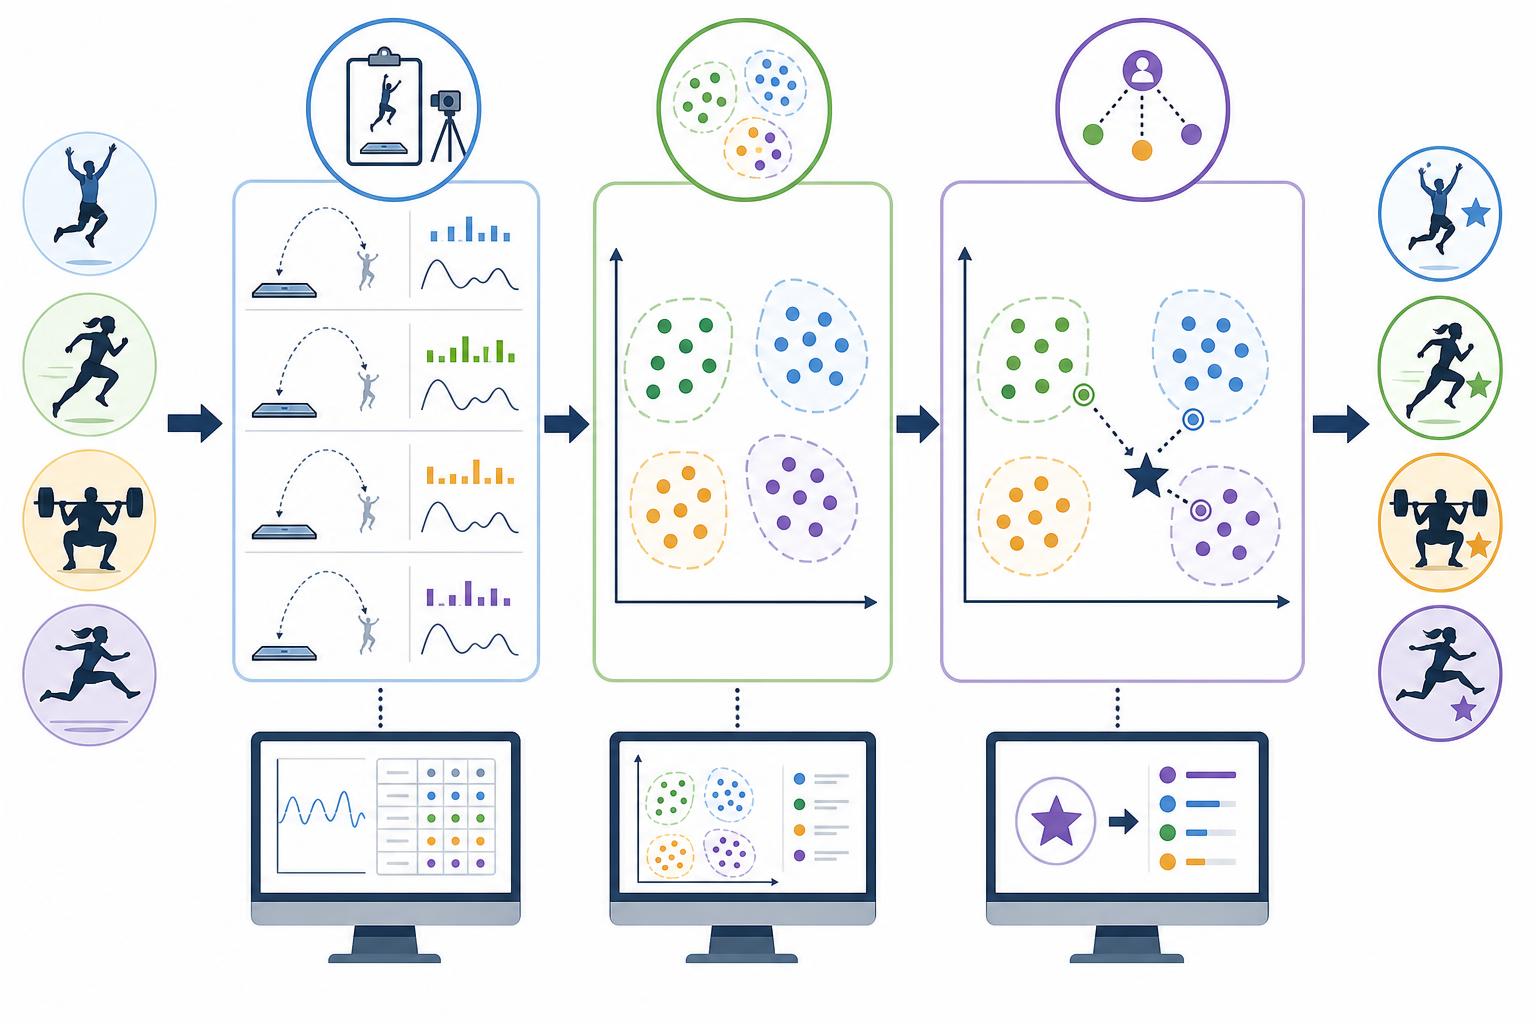
Veámoslo sobre el terreno: se parte de la misma data clásica (ejemplo: valores de braking y propulsive impulse en el CMJ recogidos en la pretemporada). Primer paso, se corre un clustering no supervisado, como k-means, sobre esas variables. El output son agrupaciones emergentes —no cuatro cuadrantes fijos, sino la cantidad y forma que indican los propios datos—. El resultado suele mostrar, muchas veces, que algunos “cuadrantes” de la lectura tradicional esconden solapamientos o subgrupos fuera del radar del corte clásico.
- Recolectar variables clave: Por ejemplo, impulsos propulsivo y de frenado de cada atleta, cuidando el control de calidad para no arrastrar outliers no representativos.
- Correr clustering (ejemplo: K-Means): Seleccioná la cantidad de clusters (usando algún criterio objetivo, como el codo de la varianza explicada), corré el algoritmo y recibí agrupaciones con límites basados en la distancia matemática entre los casos, no en la media.
- Visualizar agrupaciones: Graficá el resultado con colores por clusters y evaluá los patrones: puede emergen dos, tres, cuatro o incluso cinco grupos. Es clave no caer en la tentación de forzar siempre el clásico cuarteto.
- Incorporar nuevos atletas: Si se suma uno nuevo en el ciclo, medís sus proxies, calculás su posición y lo asignás vía KNN al cluster más próximo (con la cantidad de vecinos más chica para evitar oversmoothing). Así el sistema se estabiliza y resiste cambios accidentales.
¿Operativamente se puede? Hoy sí, y con un costo-barrera técnico bajo. Las suites comunes (R, Python, incluso Excel con plugins o Power BI) resuelven clustering y KNN en minutos. El verdadero límite no es la practicidad, sino la honestidad interpretativa: aceptar lo que emerge, aunque no calce en etiquetas cómodas, y dejar de imponerle una estructura arbitraria a la data. Requiere también un trabajo de integración: los clusters deben rebotar en la discusión del staff y, sobre todo, reflejarse en propuestas que cambien la programación. El análisis no suma si no se traduce en una acción concreta. Un cluster que no modifica nada es puro decorado en el dashboard.
Comparando interpretaciones: cuadrantes clásicos vs clustering real
El valor del clustering no es meramente descubrir “grupos distintos” que antes estaban tapados, sino cómo cambia el razonamiento posterior que hacemos como staff. Bajo el cuadrante tradicional, la conversación se vuelve binary: “este atleta cayó acá, por lo tanto le toca tal feedback o ajuste programático”. Eso facilita la operativa, pero en contextos complejos —donde la calidad del proceso decide más que la simplicidad del dashboard—, es insuficiente.
Con clustering, aparecen situaciones donde:
- Un atleta clasificado como “déficitario” en cuadrante puede, visto desde los clusters, estar en un grupo mixto con requerimientos más específicos; el feedback debería ser diferencial y ajustarse a la particularidad, en vez de aplicar templates universales.
- Se detectan clusters pequeños que los cuadrantes absorben dentro de un grupo mayor; estos subgrupos suelen coincidir con casos clínicos, readaptados, juveniles o atletas con especializaciones técnicas subordinadas a tareas de juego que el cluster revela, pero el cuadrante ignora. Tener esa foto cambia el orden de prioridades del staff y abre la puerta a microprogramaciones más finas.
- En cohortes históricas, el clustering permite comparar si el patrón de agrupamientos se mantiene o si aparecen perfiles nuevos que antes eran invisibles—esto suma al monitoreo longitudinal y la calibración de programas. El cuadrante, en cambio, destruye parte de esa trazabilidad por modificar su sentido cada vez que la media se ajusta o el grupo cambia.
Por ejemplo, en un análisis aplicado, descubrís que el año pasado todos los extremos del equipo quedaban en el “cuadrante débil-explosivo”, pero el clustering actual muestra que, aunque tres repitieron esos outputs, dos cayeron a un cluster minoritario que exige otro tipo de seguimiento. Esa distinción no solo es relevante para la programación de cargas, sino también para ajustar criterios de regreso de lesión, reacondicionamiento y hasta discutir con el médico y el fisio qué implica “ser igual que antes”.
En síntesis: los cuadrantes comunican y segmentan rápido; los clusters muestran naturaleza real y permiten decidir intervenciones más alineadas al perfil verdadero del atleta. La utilidad, en definitiva, está en elegir qué herramienta responde a la pregunta-clave del momento—si el objetivo es awareness o diagnóstico macro, el cuadrante sirve. Si la meta es programar micro-cargas, recetar drills o construir trayectorias individuales, el clustering y la clasificación basada en data tienen más cuerda.
¿Cuándo y cómo adoptar estas herramientas en el proceso de staff?
No se trata de caer en la trampa del gadget nuevo: el clustering suma cuando el contexto pide ir más allá del pantallazo visual y cuando hay un compromiso real con usar la data para individualizar o redefinir prioridades de desarrollo. Si tu muestra es chica (menos de 20-30), el valor agregado será limitado versus la claridad comunicacional del cuadrante. Si tu proceso requiere respuestas rápidas para awareness grupal o motivación, lo visualmente directo del cuadrante sigue funcionando. Pero cuando la realidad operativa es “¿a quién realmente le conviene ajustar tal carga, progresión o feed específico?”, y existe variabilidad significativa en el grupo, el clustering (combinado con KNN) te puede dar perfiles más sólidos para acciones personalizadas.
Ruta mínima útil:
- Seguir usando cuadrantes para comunicación y screening inicial; no descartarlos, sino ubicarlos como lo que son: una foto de estado, no un mapa definitivo.
- Correr clustering para fundamentar intervenciones diferenciadas, evitar falsas clasificaciones y priorizar recursos, sobre todo si la oferta de recursos/time/atención individual a atletas es limitada y querés apuntar el tiro fino.
- Usar KNN solo cuando sea necesario incorporar nuevos atletas de forma sistematizada al banco de perfiles previos (útil en staffs con mucha rotación o ciclos pretemporada-largo plazo).
Otras claves para elegir bien:
- Si no tenés tiempo para capacitación técnica y el staff necesita resultados en menos de una semana, la curva del clustering puede pesar más que el beneficio. Mejor quedarse en cuadrante y ajustar la interpretación.
- Si la variabilidad interna del grupo es bajísima (ejemplo: elite homogénea), lo que se detecte como cluster puede tener poco valor operativo.
- Si tus recursos de medición tienen mucho error (plataformas de salto low-cost, malos controles de setting), los clusters planteados pueden responder más a errores que a proceso real. Acá tampoco suma complicar por sumar.
La ecuación es la de siempre: más complejidad solo suma si mejora la calidad del proceso o resuelve un problema que antes era invisible. No porque la moda machine learning arrase, sino porque la brecha entre la categoría impuesta y el perfil verdadero impacta directamente en el margen de error para decidir y monitorear. Alinear la herramienta a la decisión concreta del lunes a la mañana sigue siendo la medida principal del valor, y esa honestidad pragmática debería guiar el escalón de sofisticación en el perfilado de cualquier staff que pretenda profesionalizar el proceso.
Conclusiones prácticas: lo que cambia (y lo que no) para el estándar profesional
Pasar de cuadrantes a clustering en el profiling de atletas no convierte mágicamente la data en acción, pero obliga a reenfocar el proceso: dejar de tapar matices por comodidad, asumir la incertidumbre y dejar que lo que emerge de la suma del grupo sea guía y no pretexto. Los cuadrantes no desaparecen: siguen sirviendo para comunicación rápida, awareness de grupo y para llevarse algo visual sencillo tras el test. Pero cuando la apuesta es elevar el estándar profesional —sea en preparación, readaptación o toma de decisiones interdisciplinaria—, sumar ese layer de análisis permite intervenir de manera más específica, robusta y con menos margen de error de categorización artificial.
En la práctica, el mayor cambio es de mentalidad: dejar de buscar certezas duras detrás de proxies y métricas simplificadas, abrazar la distribución real y trabajar sobre perfiles nacidos del propio contexto, no de la media del cohort del año pasado. El clustering y el KNN son apenas herramientas para eso: elegir usarlas no es una cuestión de moda, sino de honestidad operativa. Si el proceso gana criterio y lenguaje común, el método ayudó. Si no, el cuadrante sigue siendo una buena foto de grupo, pero no una radiografía del atleta real.